Leetcode Basic
Vector
vector<int> nums;   // Create an empty vector
vector<int> nums(n, 0); // creat an vector with 0
| Function | Description | Example |
|---|---|---|
size() |
Returns the number of elements | nums.size() |
empty() |
Returns whether the vector is empty | nums.empty() |
push_back(x) |
Adds an element to the end | nums.push_back(5); |
pop_back() |
Removes the last element | nums.pop_back(); |
back() |
Returns the last element | nums.back() |
front() |
Returns the first element | nums.front() |
clear() |
Removes all elements | nums.clear(); |
resize(n) |
Changes the size of the vector | nums.resize(10); |
int to string to_string(x)
C++ STL
std::string
函数操作基本和vector一致
| 操作 | 写法 | 说明 |
|---|---|---|
| 长度 | s.size() |
字符串长度 |
| 是否为空 | s.empty() |
空返回 true |
| 清空 | s.clear() |
变成 "" |
| 访问 | s[i] |
第 i 个字符 |
| 第一个 | s.front() |
第一个字符 |
| 最后一个 | s.back() |
最后一个字符 |
| 尾部加字符 | s.push_back('a') |
末尾加入 'a' |
| 尾部删字符 | s.pop_back() |
删除最后一个字符 |
| 拼接 | s += "abc" |
末尾加字符串 |
| 插入 | s.insert(2, "abc") |
index 2 前插入 |
| 删除 | s.erase(pos, len) |
从 pos 删除 len 个 |
| 截取 | s.substr(pos, len) |
从 pos 截取 len 个 |
| 查找 | s.find("abc") |
找第一次出现的位置 |
| 反向查找 | s.rfind("abc") |
找最后一次出现的位置 |
| 替换 | s.replace(pos, len, "xx") |
替换一段 |
| 比较 | s1 == s2 |
判断相等 |
std::queue
一头进,另一头出 → 先进先出(FIFO)
一般多用于bfs
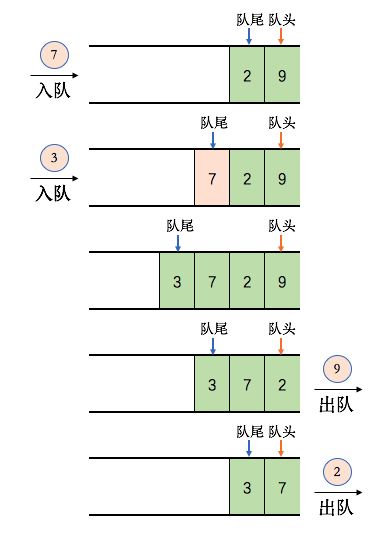
头文件:
#include <queue>std::queue<int> q; q.push(1); // 入队 q.front(); // 获取队首元素 q.pop(); // 出队 (没有返回值) q.empty(); // 判断是否为空 q.size(); // 获取大小
std::stack
一头进,一头出 → 后进先出(LIFO)
用栈这个数据结构有一个特点,每次加一个新的元素永远不断找目前栈顶的元素和自己的大小关系,由于我们入栈的顺序一般也是按index,所以每次都在找之前进去过的。
然后最好用的算法都是单调栈,每次入栈一个新的数保证栈里面所有的数都比这个数大或者小
所以用于比较
- 所有在num[i]之前入栈的元素和num[i]的大小关系 → 保持字符串组成的数字序列永远最小,数字越小的数位越靠前(高位),整个数字就越小
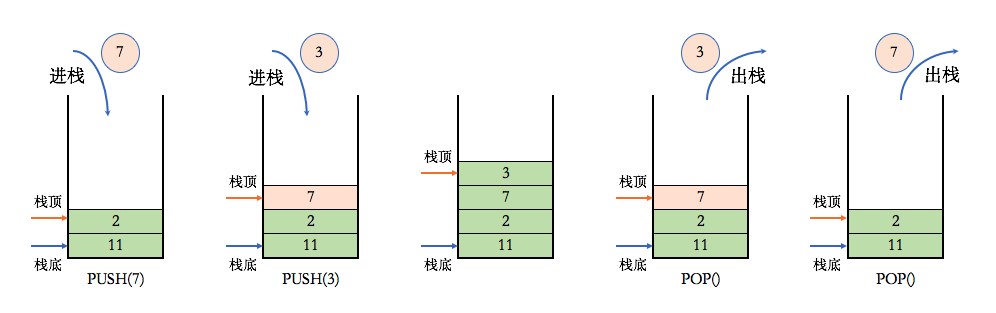
st.push(5);     // 入栈
st.push(10);

st.top();       // 查看栈顶 -> 10
st.pop();       // 删除栈顶,注意不返回值

st.empty();     // 是否为空
st.size();      // 栈里有几个元素
std::deque
双头普通队列,双头队列是可以自由控制从头进还是尾进,头出还是尾巴出,永远知道头尾是什么
头文件:
#include <deque>用处之一解决滑动窗口最大值问题,严格保证队头最大,从队头删除队尾加入
  std::deque<int> dq;
  dq.push_back(1);   // 尾部插入
  dq.push_front(2);  // 头部插入
  dq.pop_back();     // 尾部删除
  dq.pop_front();    // 头部删除
  dq[i];             // 随机访问
其中最实用的单调队列
stack |
queue |
deque |
|
|---|---|---|---|
| 加入 | push() |
push() |
push_front() / push_back() |
| 删除 | pop() |
pop() |
pop_front() / pop_back() |
| 看要出去的 | top() |
front() |
front() / back() |
| 看最后进来的 | top() |
back() |
front() / back() |
| 随机访问 | ❌ | ❌ | q[i] ✅ |
| 顺序 | 后进先出 | 先进先出 | 两头都可以进出 |
| 空判断 | empty() |
empty() |
empty() |
| 大小 | size() |
size() |
size() |
std::priority_queue
优先队列,使用heap实现
头文件:
#include <queue>// 大顶堆(默认) std::priority_queue<int> pq; // 小顶堆 std::priority_queue<int, vector<int>, std::greater<int>> pq; pq.push(1); // 入队 pq.top(); // 获取堆顶元素 pq.pop(); // 出队 pq.empty(); // 判断是否为空 pq.size(); // 获取大小如果要自定义比较器:
堆里面重载是要重载运算符写法和普通结构体不一样
struct your_struct { ... }
struct cmp {
    bool operator() (const your_struct& a, const your_struct& b) {
        return ...;  // compare your struct
    }
}

std::priority_queue<your_struct, vector<your_struct>, cmp> pq;
// normal struct

static bool cmp (const Node& a, const Node& b){
        return ...;
}
std::set 集合
集合中元素有序,不会有重复元素
头文件:
#include <set>添加:
.insert()- 如果添加的元素是结构体,必须重载
operator<
- 如果添加的元素是结构体,必须重载
删除:
.erase()判断元素是否存在:
.count()遍历:
for (auto it = s.begin(); it != s.end(); ++it) { *it; }
std::unordered_set 无序集合
也保证不会有重复元素
- 头文件:
#include <unordered_set> - 跟
std::set的使用方法相同,区别在于std::set用红黑树,std::unordered_set用哈希表
std::unordered_map 哈希表
一个key只能对应一个value不会重复
头文件:
#include <unordered_map>添加元素: 下标添加或
.insert( {key, value} ).如果添加的是重复的key, 则使用下标会修改value,使用insert不会修改value.
查找元素用[]下标,
.at()或者.find:if (m.find(key)) != m.end()) { ... }删除:
.erase( key )遍历:
for (auto iter = m.begin(); iter != m.end(); iter++) { }key =
iter->first, value =iter->second.std::unordered_map<int, std::string> m; // insert m[1] = "one"; m.insert({2, "second"}); m.insert(std::make_pair(3, "third")); m[1] = "first"; // will modify value m.insert({3, "three"}); // will not overwrite value // access std::cout << m[0] << '\n'; // output empty std::cout << m[1] << '\n'; // "first" std::cout << m.at(2) << '\n'; // "second" std::cout << m.at(-1) << '\n'; // std::out_of_range exception auto iter = m.find(3); // new iteration method for hash map if (iter != m.end()) { // key = iter->first, value = iter->second std::cout << "key " << iter->first << " value " << iter->second << '\n'; } for ( auto& [key, value]: m){ cout << key << ',' << value << '\n'; } // traverse for (auto iter = m.begin(); iter != m.end(); iter++) { // key = iter->first, value = iter->second std::cout << "key " << iter->first << " value " << iter->second << '\n';
哈希表的应用:
- 统计每个item的出现次数
- 统计每个item的下标,以及是否出现经典
key=number,value=index
std::unordered_multimap 也是哈希表,但允许重复的key
头文件:
#include <map>插入元素: 不能使用operator[], 只能使用
.insert查找指定key的一个元素:
.find( key )查找key的所有元素:
.equal_range( key )auto range = m.equal_range (key)for (auto it = range.first; it != range.second; ++it) { }
  std::unordered_multimap<int, std::string> m;

  // insert
  m.insert({1, "one"});
  m.insert({1, "first"});
  // m[1] = "one";  // no such operator!
  m.insert({2, "second"});

  // access
  std::cout << m.count(3) << '\n';
  std::cout << m.count(1) << '\n';
  auto range = m.equal_range(1);
  for (auto it = range.first; it != range.second; ++it) {
      std::cout << "key " << it->first << " value " << it->second << '\n';
  }